Các mô hình truyền thống (Naive Bayes, Logistic Regression, SVM)
Mô hình tuần tự (RNN, LSTM)
Mô hình ngữ cảnh (DistilBERT fine-tuned)
Khám phá dữ liệu (EDA)
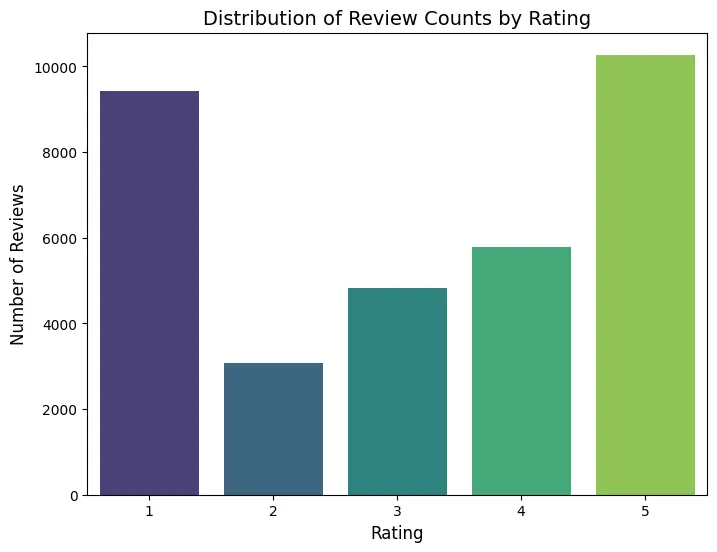
Tập dữ liệu mất cân bằng: nhiều đánh giá 1⭐ và 5⭐ → cần class weighting trong huấn luyện.
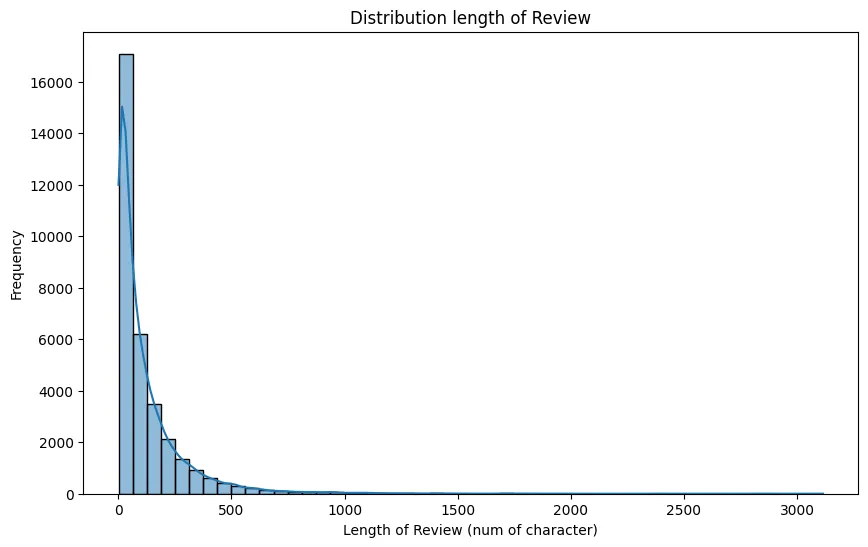
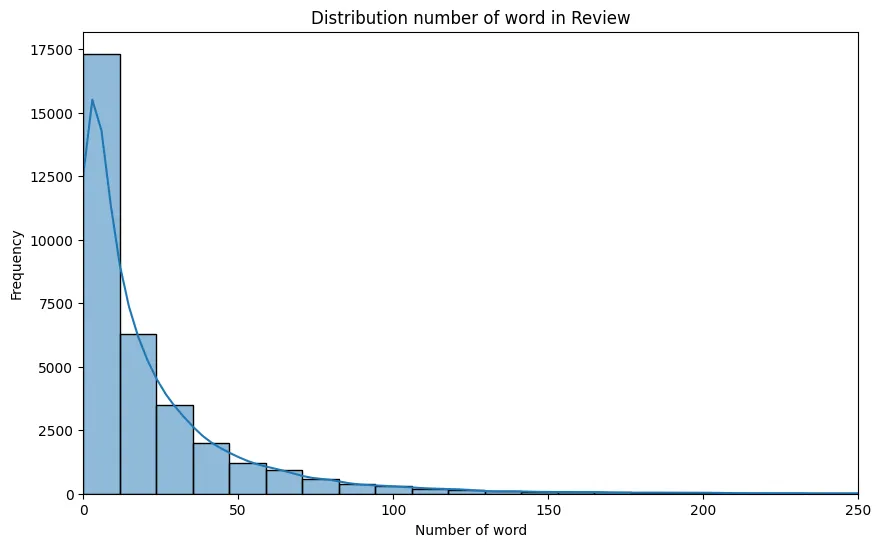
Độ dài bình luận thay đổi mạnh — có những đánh giá chỉ vài từ và cũng có đoạn mô tả dài hơn 100 từ.
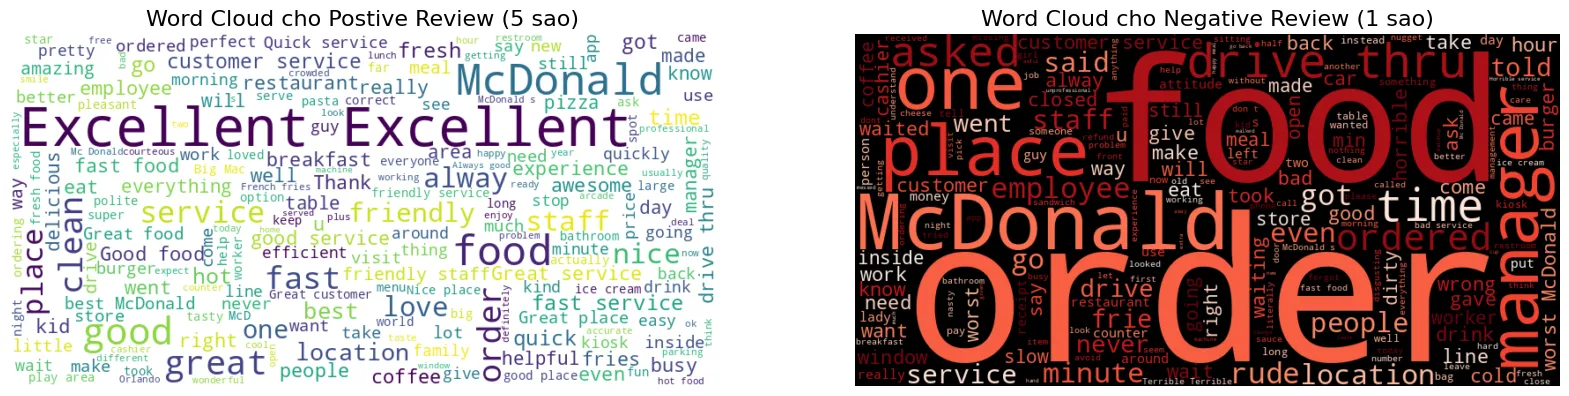
WordCloud — Trực quan hoá ngôn ngữ
Từ thường gặp trong đánh giá tích cực: “Excellent”, “McDonald”, “good”, “food”
Từ thường gặp trong đánh giá tiêu cực: “food”, “order”, “McDonald”
Kết quả thực nghiệm
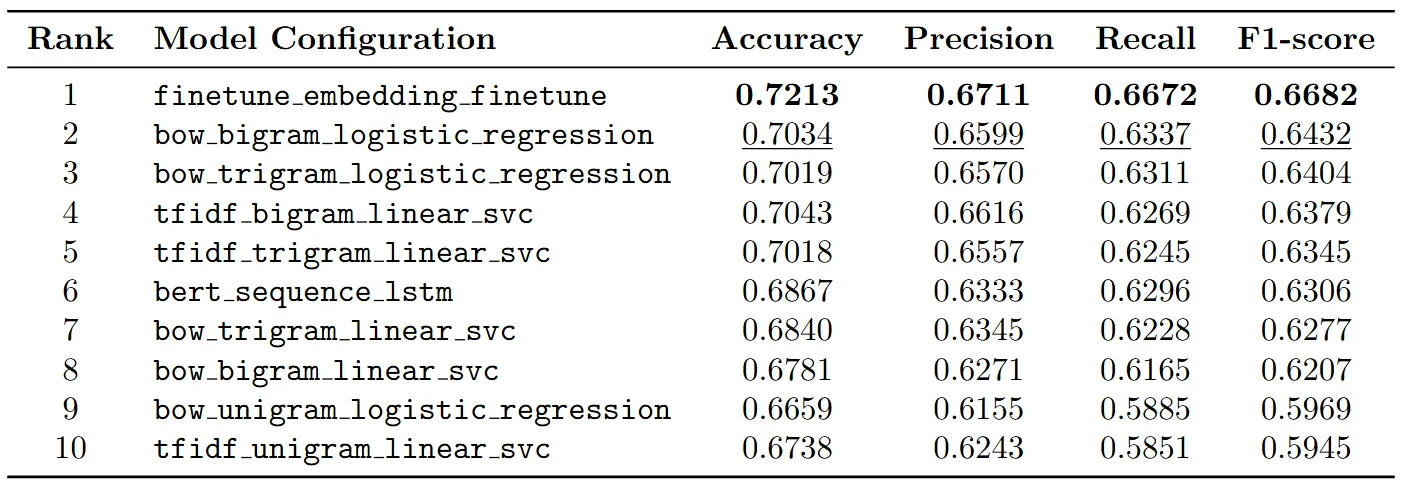
Bảng kết quả top 10 thí nghiệm theo (Macro F1 score).
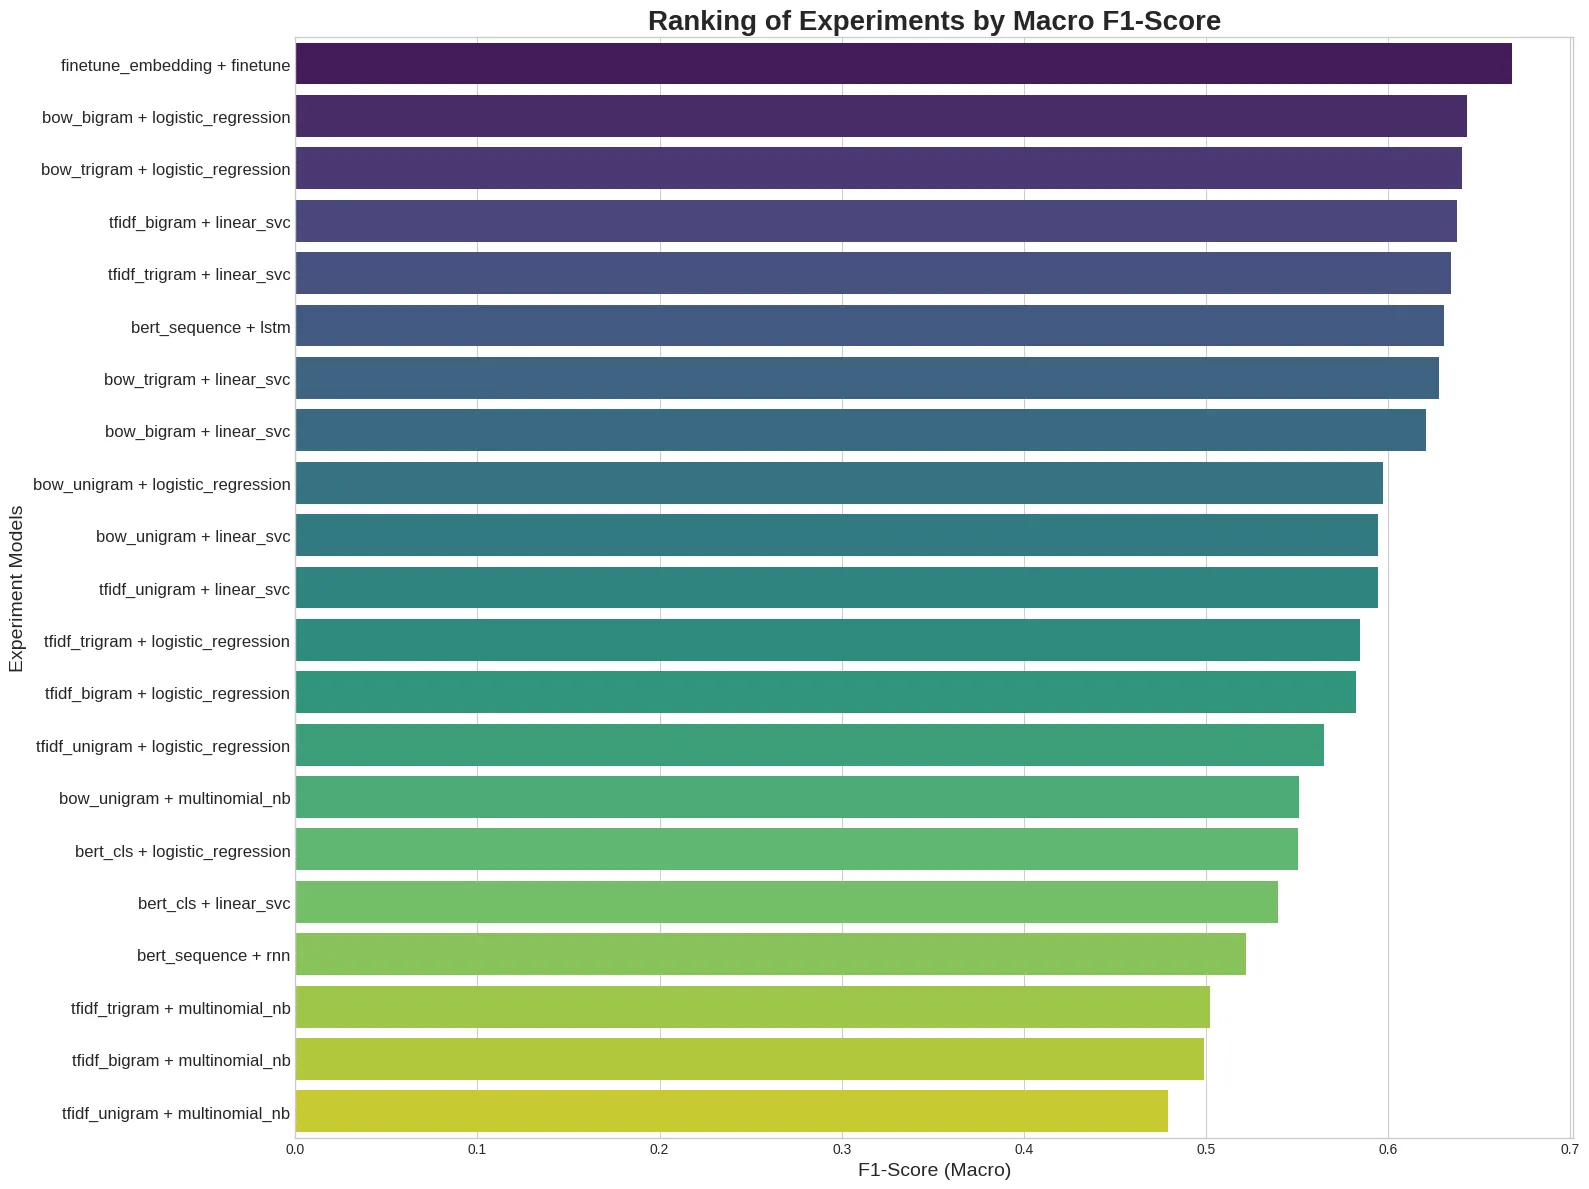
So sánh hiệu năng giữa các mô hình dựa trên F1-score.
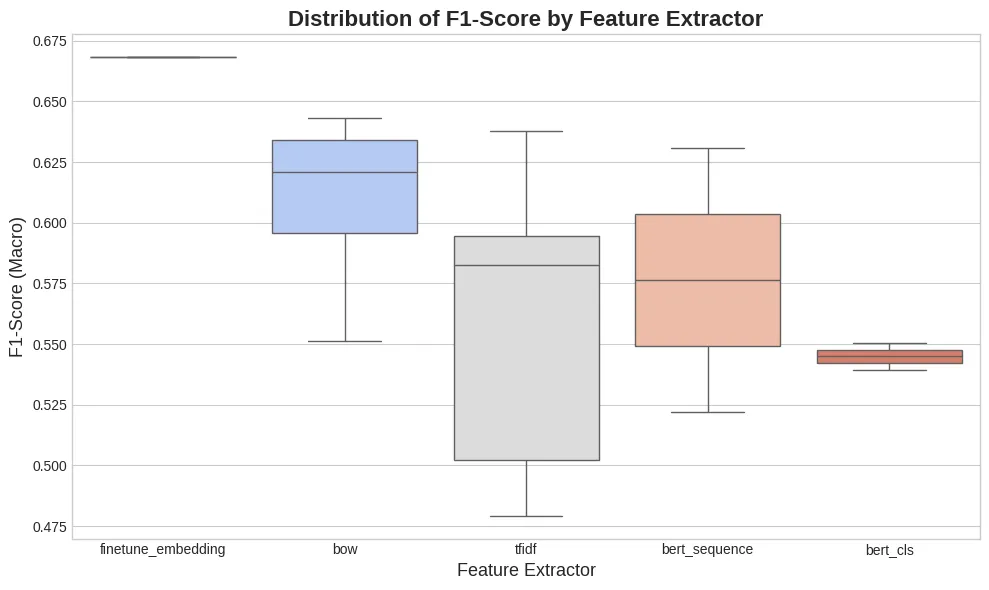
Phân phối F1-score giữa các phương pháp trích xuất đặc trưng khác nhau.
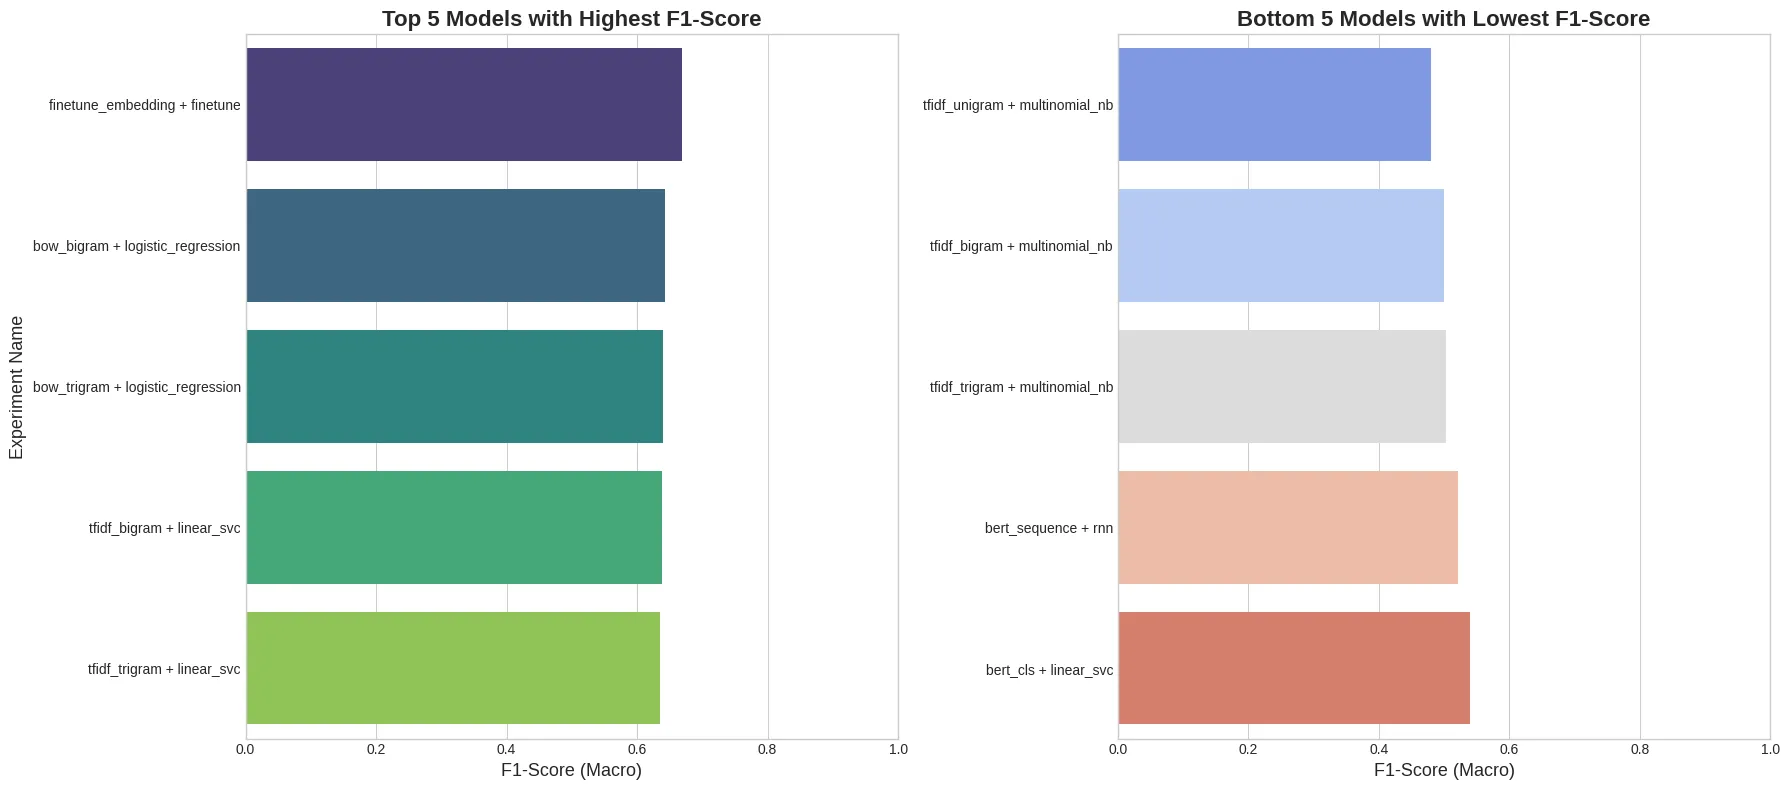
Hiệu năng của 5 mô hình có F1-score cao nhất và thấp nhất.
Nhận xét nhanh
DistilBERT dẫn đầu (F1 ≈ 0.668) nhờ khả năng hiểu ngữ cảnh và biểu diễn ngữ nghĩa sâu.
BoW + Logistic Regression (Bigram/Trigram) đạt hiệu năng cao, chứng minh mô hình tuyến tính vẫn hiệu quả khi đặc trưng được chọn hợp lý.
TF-IDF + Linear SVC ổn định và cạnh tranh, là lựa chọn cân bằng giữa hiệu năng và chi phí huấn luyện.
BERT Sequence + LSTM không cải thiện đáng kể, cho thấy việc chồng thêm tầng tuần tự không luôn mang lại lợi ích khi dữ liệu hạn chế.
BoW/TF-IDF Unigram cho kết quả thấp hơn rõ rệt → khẳng định tầm quan trọng của đặc trưng ngữ cảnh (n-gram).
💡 Điểm sáng: Các mô hình truyền thống (Logistic Regression, SVM) kết hợp với TF-IDF hoặc BoW vẫn đạt kết quả tốt, cạnh tranh mạnh mẽ với transformer nếu được tinh chỉnh tốt.